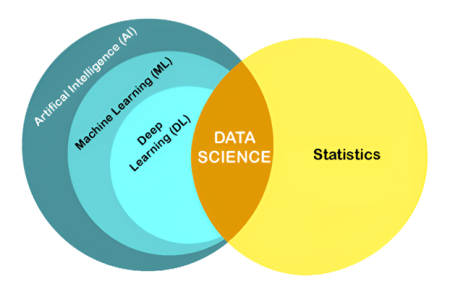
পরিসংখ্যান এআই প্রকৌশলের একটি মূল অংশ কারণ এটি আমাদের ডেটা বুঝতে, সিদ্ধান্ত নিতে এবং বুদ্ধিমান সিস্টেম তৈরি করতে সহায়তা করে। এই নিবন্ধে, আমরা পাইথন ব্যবহার করে মেশিন লার্নিং এর প্রেক্ষাপটে এআই প্রকৌশলে পরিসংখ্যান (Statistics) নিয়ে আলোচনা করব।
পরিসংখ্যান কী?
পরিসংখ্যান এআই প্রকৌশলের একটি গুরুত্বপূর্ণ অংশ কারণ এটি আমাদের ডেটাতে কী ঘটছে তা বুঝতে সাহায্য করে। এটি গণিতের একটি শাখা যা ডেটা সংগ্রহ, বিশ্লেষণ, ব্যাখ্যা এবং উপস্থাপনার উপর মনোযোগ দেয়। এটি আমাদের তথ্যকে একটি পরিষ্কার এবং কার্যকর উপায়ে সাজাতে সাহায্য করে যাতে আমরা বুঝতে পারি ডেটা আমাদের কী বলছে। একটি সংখ্যার সেটের গড় খুঁজে বের করা হোক বা ডেটা পয়েন্টগুলো কীভাবে ছড়িয়ে আছে তা বোঝা হোক, পরিসংখ্যান আমাদের ডেটা নিয়ে কাজ করার জন্য মৌলিক পদ্ধতি সরবরাহ করে।
এআই-তে, আমরা প্রায়শই মডেল প্রশিক্ষণের জন্য প্রচুর পরিমাণে ডেটা নিয়ে কাজ করি যা প্যাটার্ন চিনতে, পূর্বাভাস দিতে বা কাজ স্বয়ংক্রিয় করতে পারে। পরিসংখ্যান আমাদের এই ডেটা একটি কাঠামোগত উপায়ে অন্বেষণ এবং বিশ্লেষণ করার সরঞ্জাম দেয়। এটি আমাদের কোন তথ্য কার্যকর তা সনাক্ত করতে, প্যাটার্ন বা প্রবণতা খুঁজে বের করতে এবং ডেটা থেকে ত্রুটি বা গোলমাল দূর করতে সাহায্য করে।
পরিসংখ্যান কীভাবে এআই প্রকৌশলে সহায়তা করে?
মেশিন লার্নিংয়ে, পরিসংখ্যান আমাদের অনেক পর্যায়ে সাহায্য করে। এটি মডেল তৈরির আগে ডেটা অন্বেষণ এবং পরিষ্কার করতে ব্যবহৃত হয়। এটি আমাদের প্যাটার্ন, প্রবণতা এবং সম্পর্কগুলো কল্পনা করতে সাহায্য করে যা প্রথম দেখাতে স্পষ্ট নাও হতে পারে। পরিসংখ্যান আমাদের সঠিক অ্যালগরিদম বেছে নিতে এবং আমাদের মডেলগুলো কতটা ভালোভাবে কাজ করছে তা মূল্যায়ন করতেও সহায়তা করে। পরিসংখ্যান সম্পর্কে দৃঢ় ধারণা না থাকলে, ডেটা থেকে সঠিক সিদ্ধান্তে পৌঁছানো বা নির্ভরযোগ্য মেশিন লার্নিং সিস্টেম তৈরি করা কঠিন হবে।
মেশিন লার্নিং এর জন্য মৌলিক পরিসংখ্যান ধারণা
মেশিন লার্নিং এর জন্য প্রয়োজনীয় কিছু গুরুত্বপূর্ণ পরিসংখ্যান ধারণা নিচে দেওয়া হলো:
- গড় (Mean), মধ্যমা (Median), প্রচুরক (Mode): এই পরিসংখ্যানিক পরিমাপগুলো একটি ডেটাসেটের কেন্দ্রীয় প্রবণতা বর্ণনা করতে ব্যবহৃত হয়।
- আদর্শ বিচ্যুতি (Standard deviation), ভিন্নতা (Variance): আদর্শ বিচ্যুতি হলো এক সেট ডেটা মানের তাদের গড়ের চারপাশে বিচ্যুতি বা বিস্তারের পরিমাণের একটি পরিমাপ।
- পার্সেন্টাইল (Percentiles): পার্সেন্টাইল হলো এমন একটি পরিমাপ যা নির্দেশ করে যে একটি নির্দিষ্ট শতাংশের পর্যবেক্ষণগুলো একটি গোষ্ঠীর পর্যবেক্ষণের নিচে পড়ে।
- ডেটা ডিস্ট্রিবিউশন (Data Distribution): এটি বোঝায় যে ডেটা পয়েন্টগুলো কীভাবে একটি ডেটাসেট জুড়ে বিতরণ বা ছড়িয়ে আছে।
- বক্রতা (Skewness) এবং সুচলতা (Kurtosis): বক্রতা একটি ডিস্ট্রিবিউশনের অপ্রতিসাম্যের মাত্রাকে বোঝায় এবং সুচলতা একটি ডিস্ট্রিবিউশনের চূড়ার মাত্রাকে বোঝায়।
- বায়াস (Bias) এবং ভ্যারিয়েন্স (Variance): এগুলো একটি মডেলের পূর্বাভাসের ত্রুটির উৎস বর্ণনা করে।
- হাইপোথিসিস (Hypothesis): এটি একটি প্রস্তাবিত ব্যাখ্যা বা একটি সমস্যার সমাধান।
- রৈখিক রিগ্রেশন (Linear Regression): এটি অন্য একটি চলকের মানের উপর ভিত্তি করে একটি চলকের মান অনুমান করতে ব্যবহৃত হয়।
- লজিস্টিক রিগ্রেশন (Logistic Regression): এটি একটি ঘটনার ঘটার সম্ভাবনা অনুমান করে।
- প্রিন্সিপাল কম্পোনেন্ট অ্যানালাইসিস (Principal Component Analysis): এটি একটি মাত্রিক হ্রাস পদ্ধতি যা বৃহৎ ডেটাসেটের মাত্রা কমানোর জন্য ব্যবহৃত হয়।
পরিসংখ্যানের প্রকারভেদ
পরিসংখ্যান দুই প্রকার – বর্ণনামূলক পরিসংখ্যান (Descriptive Statistics) এবং অনুমিত পরিসংখ্যান (Inferential Statistics)।
বর্ণনামূলক পরিসংখ্যান (Descriptive Statistics)
বর্ণনামূলক পরিসংখ্যান হলো পরিসংখ্যানের একটি অংশ যা আমাদের দ্রুত ডেটা বুঝতে এবং সংক্ষিপ্ত করতে সাহায্য করে। এতে গড় (গড়), মধ্যমা (মাঝের মান), প্রচুরক (সবচেয়ে বেশি বার আসা মান), ভিন্নতা এবং আদর্শ বিচ্যুতির (ডেটা কতটা ছড়িয়ে আছে) মতো মৌলিক পরিমাপগুলো অন্তর্ভুক্ত থাকে। এই পরিমাপগুলো আমাদের ডেটার সামগ্রিক আচরণ সম্পর্কে একটি পরিষ্কার ধারণা পেতে সাহায্য করে, যেমন বেশিরভাগ মান কোথায় কেন্দ্রীভূত, তারা কতটা পরিবর্তিত হয় এবং কীভাবে বিতরণ করা হয়।
মেশিন লার্নিংয়ে, বর্ণনামূলক পরিসংখ্যান ডেটা সংক্ষিপ্ত করতে, আউটলায়ার শনাক্ত করতে এবং প্যাটার্ন খুঁজে বের করতে ব্যবহৃত হতে পারে। উদাহরণস্বরূপ, আমরা একটি ডেটাসেটের ডিস্ট্রিবিউশন বর্ণনা করতে গড় এবং আদর্শ বিচ্যুতি ব্যবহার করতে পারি। পাইথনে, আমরা NumPy এবং Pandas-এর মতো লাইব্রেরি ব্যবহার করে বর্ণনামূলক পরিসংখ্যান গণনা করতে পারি। নিচে একটি উদাহরণ দেওয়া হলো:
import numpy as np
import pandas as pd

data = np.array([1, 2, 3, 4, 5])
df = pd.DataFrame(data, columns=["Values"])
print(df.describe())
নিম্নলিখিত ফলাফলগুলো ডেটাসেটটির একটি সারসংক্ষেপ দেবে, যার মধ্যে মোট সংখ্যা, গড়, আদর্শ বিচ্যুতি, সর্বনিম্ন এবং সর্বোচ্চ মান অন্তর্ভুক্ত থাকবে।
         Values
count    5.000000
mean     3.000000
std      1.581139
min      1.000000
25%      2.000000
50%      3.000000
75%      4.000000
max      5.000000
অনুমানমূলক পরিসংখ্যান (Inferential Statistics)
অনুমানমূলক পরিসংখ্যান হলো পরিসংখ্যানের একটি অংশ যা একটি বৃহত্তর গোষ্ঠী (যাকে জনসংখ্যা বা Population বলা হয়) সম্পর্কে ভবিষ্যদ্বাণী করতে বা সিদ্ধান্তে পৌঁছাতে সাহায্য করে, যা তার একটি ছোট অংশ (যাকে নমুনা বা Sample বলা হয়) দেখে করা হয়। প্রতিটি একক ডেটা পয়েন্ট অধ্যয়ন করার পরিবর্তে, আমরা একটি নমুনা অধ্যয়ন করি এবং হাইপোথিসিস টেস্টিং, কনফিডেন্স ইন্টারভ্যাল এবং রিগ্রেশন অ্যানালাইসিসের মতো পদ্ধতি ব্যবহার করে সমগ্র জনসংখ্যা সম্পর্কে শিক্ষিত অনুমান করি। যখন সবার কাছ থেকে ডেটা সংগ্রহ করা সম্ভব বা ব্যবহারিক নয়, তখন এটি খুবই কার্যকর।
মেশিন লার্নিংয়ে, অনুমানমূলক পরিসংখ্যান বিদ্যমান ডেটার উপর ভিত্তি করে নতুন ডেটা সম্পর্কে ভবিষ্যদ্বাণী করতে ব্যবহার করা যেতে পারে। উদাহরণস্বরূপ, আমরা একটি বাড়ির বৈশিষ্ট্য, যেমন বেডরুম এবং বাথরুমের সংখ্যার উপর ভিত্তি করে তার দাম অনুমান করার জন্য রিগ্রেশন অ্যানালাইসিস ব্যবহার করতে পারি। পাইথনে, আমরা Scikit-Learn এবং StatsModels-এর মতো লাইব্রেরি ব্যবহার করে অনুমানমূলক পরিসংখ্যান সম্পাদন করতে পারি। নিচে একটি উদাহরণ দেওয়া হলো:
import statsmodels.api as sm
import numpy as np

X = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 6, 8, 10])

X = sm.add_constant(X)
model = sm.OLS(y, X).fit()

print(model.summary())
এই মৌলিক ধারণাগুলো একজন মেশিন লার্নিং প্রকৌশলীকে ডেটা বিশ্লেষণ, মডেল নির্বাচন এবং কর্মক্ষমতা মূল্যায়নে আত্মবিশ্বাসী করে তোলে।
