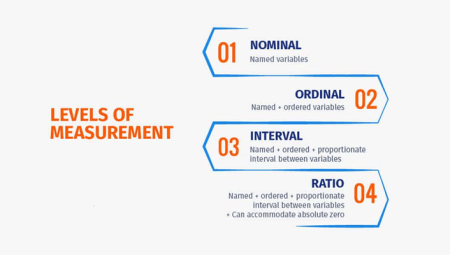
ডেটা সাইন্স বা মেশিন লার্নিং নিয়ে কাজ শুরু করার আগে সবচেয়ে গুরুত্বপূর্ণ বিষয় হলো আমাদের ডেটাকে ভালোভাবে চেনা এবং বোঝা। আমরা যে ডেটা নিয়ে কাজ করছি, তা কোন ধরণের? তার বৈশিষ্ট্য কী? এই প্রশ্নগুলোর উত্তর দেয় পরিসংখ্যানের একটি কোর কনসেপ্ট, যার নাম Levels of Measurement বা পরিমাপের স্তর।
সঠিকভাবে ডেটার স্তর বুঝতে পারলে আমরা জানতে পারি কোন ডেটার উপর কী ধরনের ম্যাথমেটিক্যাল অপারেশন (যোগ, বিয়োগ, গুণ, ভাগ) করা যাবে এবং কোন ধরনের স্ট্যাটিস্টিক্যাল মডেল বা চার্ট ব্যবহার করা উচিত। আমরা যখন কোনো ডেটা সংগ্রহ করি, তখন সেই ডেটাকে মাপার (measurement) ধরন অনুযায়ী চার ভাগে ভাগ করা হয়। চলুন, এই চারটি স্তরকে সহজ উদাহরণ এবং পাইথন কোড দিয়ে বুঝে নেওয়া যাক।
১. নমিনাল ডেটা (Nominal Data)
সবচেয়ে সহজ স্তরের ডেটা হলো নমিনাল। Nominal শব্দটি ল্যাটিন “nomen” থেকে এসেছে, যার অর্থ “নাম”।
- বৈশিষ্ট্য:
- এই ডেটা শুধুমাত্র লেবেল বা নাম বোঝানোর জন্য ব্যবহৃত হয়।
- এদের মধ্যে কোনো নির্দিষ্ট ক্রম বা অর্ডার নেই।
- আপনি বলতে পারবেন না যে একটি অন্যটির চেয়ে বড় বা ভালো।
- এদের উপর কোনো গাণিতিক অপারেশন (যোগ, বিয়োগ) করা যায় না।
- বাস্তব জীবনের উদাহরণ:
- মানুষের লিঙ্গ (পুরুষ, মহিলা, অন্যান্য)।
- রক্তের গ্রুপ (A, B, AB, O)।
- শহরের নাম (ঢাকা, চট্টগ্রাম, খুলনা)।
- ফলের নাম (আম, জাম, কলা)।
পাইথন উদাহরণ: সাধারণত, নমিনাল ডেটা নিয়ে কাজ করার সময় আমরা জানতে চাই কোন ক্যাটাগরিতে কতগুলো ডেটা আছে। এর জন্য পাইথনের Pandas লাইব্রেরি খুব কাজের।
import pandas as pd

# কিছু শহরের নামের একটি তালিকা (লিস্ট)
city_data = ['ঢাকা', 'চট্টগ্রাম', 'ঢাকা', 'খুলনা', 'সিলেট', 'চট্টগ্রাম', 'ঢাকা']

# এটিকে একটি Pandas Series এ রূপান্তর করি
city_series = pd.Series(city_data)

# কোন শহর কতবার আছে তা গণনা করি
print("শহরের সংখ্যা গণনা:")
print(city_series.value_counts())
এখানে আমরা সহজেই দেখতে পাচ্ছি কোন ক্যাটাগরি কতবার এসেছে, কিন্তু ‘ঢাকা’ > ‘চট্টগ্রাম’ এমন কোনো তুলনা এখানে অর্থহীন।
২. অর্ডিনাল ডেটা (Ordinal Data)
Ordinal শব্দটি “order” বা ক্রম থেকে এসেছে। এই ডেটার মধ্যে একটি নির্দিষ্ট ক্রম বা র্যাংকিং থাকে।
- বৈশিষ্ট্য:
- এই ডেটাগুলোকে ছোট থেকে বড় বা ভালো থেকে খারাপ ক্রমে সাজানো যায়।
- কিন্তু দুটি মানের মধ্যেকার পার্থক্য সমান বা পরিমাপযোগ্য নয়।
- অর্থাৎ, ‘ভালো’ এবং ‘খুব ভালো’-এর মধ্যেকার পার্থক্য আর ‘খুব ভালো’ এবং ‘চমৎকার’-এর মধ্যেকার পার্থক্য সমান নাও হতে পারে।
- বাস্তব জীবনের উদাহরণ:
- শিক্ষাগত যোগ্যতা (SSC, HSC, Bachelor’s, Master’s)।
- টি-শার্টের সাইজ (Small, Medium, Large, XL)।
- কাস্টমার সন্তুষ্টির রেটিং (খুব খারাপ, খারাপ, ভালো, খুব ভালো)।
পাইথন উদাহরণ: Pandas ব্যবহার করে আমরা এই ডেটার অর্ডার বা ক্রম নির্দিষ্ট করে দিতে পারি, যা ডেটা অ্যানালাইসিসের জন্য খুব গুরুত্বপূর্ণ।
import pandas as pd

# টি-শার্ট সাইজের একটি তালিকা
shirt_sizes = ['Medium', 'Large', 'Small', 'Large', 'XL', 'Medium', 'Small']

# সাইজগুলোর ক্রম নির্ধারণ করে দেই
size_order = ['Small', 'Medium', 'Large', 'XL']

# ডেটাগুলোকে Categorical টাইপে রূপান্তর করি এবং অর্ডার নির্দিষ্ট করি
size_series = pd.Categorical(shirt_sizes, categories=size_order, ordered=True)

# এখন ডেটাগুলোকে তাদের ক্রম অনুযায়ী সাজাই
print("ক্রম অনুযায়ী সাজানো টি-শার্ট সাইজ:")
print(pd.Series(size_series).sort_values())
এখানে দেখুন, আমরা সফলভাবে ডেটাগুলোকে তাদের প্রাকৃতিক ক্রম অনুযায়ী সাজাতে পেরেছি।
৩. ইন্টারভ্যাল ডেটা (Interval Data)
এই স্তরের ডেটার মধ্যে ক্রম থাকে এবং প্রতিটি মানের মধ্যেকার ব্যবধান বা পার্থক্য সমান ও পরিমাপযোগ্য হয়।
- বৈশিষ্ট্য:
- ডেটাগুলো অর্ডার করা যায় এবং তাদের মধ্যেকার পার্থক্য সমান।
- এর একটি গুরুত্বপূর্ণ বৈশিষ্ট্য হলো, এর কোনো প্রকৃত শূন্য (True Zero) মান নেই। অর্থাৎ, শূন্য মানটি কোনো কিছুর অনুপস্থিতি বোঝায় না।
- এই ডেটার উপর যোগ এবং বিয়োগ করা যায়, কিন্তু গুণ বা ভাগ অর্থপূর্ণ নয়।
- বাস্তব জীবনের উদাহরণ:
- তাপমাত্রা (সেলসিয়াস বা ফারেনহাইট): ২০°C এবং ৩০°C এর মধ্যেকার পার্থক্য (১০°C) আর ৩০°C এবং ৪০°C এর মধ্যেকার পার্থক্য (১০°C) সমান। কিন্তু আমরা বলতে পারি না যে ৪০°C তাপমাত্রা ২০°C তাপমাত্রার দ্বিগুণ গরম। কারণ ০°C মানে তাপমাত্রার অনুপস্থিতি নয়।
- IQ স্কোর: ১২০ IQ এবং ১৩০ IQ এর মধ্যেকার পার্থক্য, ১৩০ এবং ১৪০ এর মধ্যেকার পার্থক্যের সমান। কিন্তু কারো IQ স্কোর ০ হওয়া সম্ভব নয় বা এর মানে বুদ্ধিমত্তার অনুপস্থিতি বোঝায় না।
পাইথন উদাহরণ: ইন্টারভ্যাল ডেটা দিয়ে আমরা পার্থক্য বের করার মতো কাজগুলো করতে পারি।
import numpy as np

# কিছু দিনের তাপমাত্রা (সেলসিয়াসে)
temperatures = np.array([15, 20, 25, 30, 35])

# প্রথম এবং দ্বিতীয় দিনের তাপমাত্রার পার্থক্য
diff1 = temperatures[1] - temperatures[0]

# তৃতীয় এবং চতুর্থ দিনের তাপমাত্রার পার্থক্য
diff2 = temperatures[3] - temperatures[2]

print(f"প্রথম দুটি তাপমাত্রার পার্থক্য: {diff1}°C")
print(f"পরের দুটি তাপমাত্রার পার্থক্য: {diff2}°C")
print(f"দুটি পার্থক্য কি সমান? {diff1 == diff2}")
৪. রেশিও ডেটা (Ratio Data)
এটি পরিমাপের সর্বোচ্চ এবং সবচেয়ে তথ্যবহুল স্তর। ইন্টারভ্যাল ডেটার সব বৈশিষ্ট্য এর মধ্যে আছে, সাথে একটি অতিরিক্ত এবং সবচেয়ে গুরুত্বপূর্ণ বৈশিষ্ট্যও রয়েছে।
- বৈশিষ্ট্য:
- এই ডেটার একটি প্রকৃত শূন্য (True Zero) মান আছে। এখানে শূন্য মানে ওই বৈশিষ্ট্যটির সম্পূর্ণ অনুপস্থিতি।
- এই ডেটার উপর সব ধরনের গাণিতিক অপারেশন (যোগ, বিয়োগ, গুণ, ভাগ) করা যায়।
- অনুপাত বা রেশিও বের করা অর্থপূর্ণ।
- বাস্তব জীবনের উদাহরণ:
- উচ্চতা বা ওজন: কারো ওজন ০ কেজি মানে তার কোনো ওজন নেই। একজন ৮০ কেজি ওজনের মানুষ ৪০ কেজি ওজনের মানুষের চেয়ে দ্বিগুণ ভারী।
- বয়স: ০ বছর বয়স মানে সময়ের শুরু। ২০ বছর বয়সী একজন মানুষ ১০ বছর বয়সীর চেয়ে দ্বিগুণ বয়সী।
- টাকার পরিমাণ: ০ টাকা মানে কোনো টাকা নেই।
- দূরত্ব: ০ কি.মি. মানে কোনো দূরত্ব অতিক্রম করা হয়নি।
পাইথন উদাহরণ: রেশিও ডেটার উপর সব ধরনের অপারেশন সম্ভব।
# দুই বন্ধুর ওজন (কেজি)
weight_friend_A = 80
weight_friend_B = 40

# যোগ এবং বিয়োগ
total_weight = weight_friend_A + weight_friend_B
weight_difference = weight_friend_A - weight_friend_B

print(f"মোট ওজন: {total_weight} কেজি")
print(f"ওজনের পার্থক্য: {weight_difference} কেজি")

# গুণ এবং ভাগ (রেশিও)
if weight_friend_B != 0:
    ratio = weight_friend_A / weight_friend_B
    print(f"A, B এর চেয়ে {ratio} গুণ ভারী।")
সারসংক্ষেপ (Levels of Measurement)
| স্তর (Level) | বৈশিষ্ট্য | উদাহরণ | অনুমোদিত অপারেশন |
| Nominal | শুধু নাম, কোনো ক্রম নেই | লিঙ্গ, শহর | গণনা (Counting) |
| Ordinal | ক্রম আছে, কিন্তু পার্থক্য অসম | রেটিং, শার্টের সাইজ | গণনা, ক্রম সাজানো |
| Interval | ক্রম আছে, পার্থক্য সমান, প্রকৃত শূন্য নেই | তাপমাত্রা (C/F), IQ | যোগ, বিয়োগ |
| Ratio | ক্রম আছে, পার্থক্য সমান, প্রকৃত শূন্য আছে | বয়স, ওজন, উচ্চতা | যোগ, বিয়োগ, গুণ, ভাগ |
ডেটা নিয়ে কাজ করার সময় তার স্তর বা লেভেল জানাটা অত্যন্ত জরুরি। এটি আপনাকে সঠিক ভিজুয়ালাইজেশন টুল (যেমন – নমিনাল ডেটার জন্য বার চার্ট, রেশিও ডেটার জন্য হিস্টোগ্রাম) বেছে নিতে এবং সঠিক স্ট্যাটিস্টিক্যাল টেস্ট প্রয়োগ করতে সাহায্য করবে। আশা করি, এই আর্টিকেলটি আপনাকে ডেটার এই চারটি স্তর সম্পর্কে একটি পরিষ্কার ধারণা দিতে পেরেছে। হ্যাপি কোডিং!
