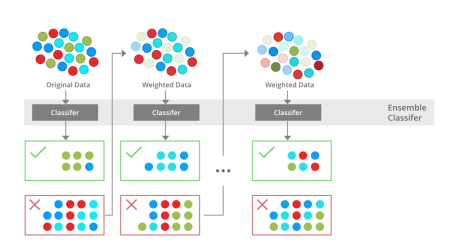
AdaBoost (Adaptive Boosting) হলো একটি Ensemble Learning Technique, যেখানে একাধিক দুর্বল (weak) মডেলকে একত্র করে একটি শক্তিশালী (strong) মডেল তৈরি করা হয়। এটি মূলত ক্লাসিফিকেশন সমস্যার জন্য ব্যবহৃত হয়, এবং সবচেয়ে জনপ্রিয় এনসেম্বল ক্লাসিফায়ারদের মধ্যে একটি।
আজ আমরা এমন একটি শক্তিশালী অ্যালগরিদম অ্যাডাবুস্ট ক্লাসিফায়ার নিয়ে আলোচনা করব যা আপনার শেখার প্রক্রিয়াকে আরও সহজ করে তুলবে। চলুন, ধাপে ধাপে এটি সম্পর্কে বিস্তারিত জেনে নিই।
AdaBoostClassifier কী?
অ্যাডাবুস্ট ক্লাসিফায়ার, যা Adaptive Boosting Classifier এর সংক্ষিপ্ত রূপ, একটি এনসেম্বল লার্নিং (Ensemble Learning) পদ্ধতি। AdaBoost এমনভাবে কাজ করে যেখানে প্রতিটি নতুন মডেল পূর্বের মডেলগুলোর ভুলের উপর ফোকাস করে। ধীরে ধীরে ভুলগুলোকে কমিয়ে একটি ভালো পারফরম্যান্স প্রদানকারী ফাইনাল মডেল তৈরি করে।
সহজ ভাষায় বলতে গেলে, AdaBoost একের পর এক দুর্বল মডেল তৈরি করে এবং প্রতিটি নতুন মডেলে আগের মডেলের ভুলগুলো থেকে শিখে সেগুলোকে সংশোধন করে। এটি মূলত ক্লাসিফিকেশন (Classification) সমস্যার জন্য ব্যবহৃত হয়।
পাইথন ব্যবহার করে অ্যাডাবুস্ট ক্লাসিফায়ার উদাহরণ
আমরা Scikit-learn লাইব্রেরি ব্যবহার করে অ্যাডাবুস্ট ক্লাসিফায়ার (AdaBoost) এর একটি সাধারণ উদাহরণ দেখব। প্রথমে, প্রয়োজনীয় লাইব্রেরিগুলো ইম্পোর্ট করি:
from sklearn.ensemble import AdaBoostClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# ১. ডেটাসেট তৈরি
X, y = make_classification(n_samples=1000, n_features=10, n_informative=5, n_redundant=0, random_state=42)

# ২. ডেটাসেটকে ট্রেনিং ও টেস্টিং সেটে ভাগ করা
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# ৩. AdaBoostClassifier মডেল তৈরি
# বেজ এস্টিমেটর হিসেবে একটি ছোট ডিসিশন ট্রি ব্যবহার করা হয় (সাধারণত max_depth=1)
base_estimator = DecisionTreeClassifier(max_depth=1)
adaboost_model = AdaBoostClassifier(estimator=base_estimator, n_estimators=100, random_state=42)

# ৪. মডেলকে ট্রেনিং ডেটাসেটে প্রশিক্ষণ দেওয়া
adaboost_model.fit(X_train, y_train)

# ৫. টেস্ট ডেটাসেটে ভবিষ্যৎবাণী করা
y_pred = adaboost_model.predict(X_test)

# ৬. মডেলের নির্ভুলতা পরিমাপ করা
accuracy = accuracy_score(y_test, y_pred)
print(f"AdaBoostClassifier এর নির্ভুলতা: {accuracy:.4f}")
এই উদাহরণে, আমরা DecisionTreeClassifier(max_depth=1) কে আমাদের দুর্বল লার্নার (Weak Learner) হিসেবে ব্যবহার করেছি। n_estimators প্যারামিটারটি নির্দেশ করে আমরা কতগুলো দুর্বল লার্নারকে একত্রিত করব।
AdaBoost অ্যালগরিদম তৈরির প্রক্রিয়া (ধাপে ধাপে)
AdaBoost অ্যালগরিদম নিম্নলিখিত ধাপে কাজ করে:
১. ডেটা ইনিশিয়ালাইজেশন (Data Initialization): ট্রেনিং ডেটাসেটের প্রতিটি স্যাম্পলকে (Sample) প্রাথমিকভাবে সমান ওজন (Weight) দেওয়া হয়। যদি টি স্যাম্পল থাকে, তাহলে প্রতিটি স্যাম্পলের ওজন হবে । ধরুন ১০০টি ডেটা পয়েন্ট আছে। শুরুতে সবগুলোর ওজন ১/১০০।
২. দুর্বল লার্নার তৈরি ও প্রশিক্ষণ (Train Weak Learner): একটি দুর্বল লার্নার (যেমন একটি ছোট ডিসিশন ট্রি) তৈরি করা হয় এবং বর্তমান ওজনের ডেটাসেটে তাকে প্রশিক্ষণ দেওয়া হয়। এই লার্নারটি কিছু স্যাম্পলকে ভুলভাবে শ্রেণীবদ্ধ (Misclassify) করবে। সাধারণত Decision Tree (stump) ব্যবহার করা হয়।
৩. লার্নার পারফরম্যান্স মূল্যায়ন (Evaluate Learner Performance): দুর্বল লার্নারের পারফরম্যান্স মূল্যায়ন করা হয়। যে স্যাম্পলগুলো ভুলভাবে শ্রেণীবদ্ধ হয়েছে, তাদের গুরুত্ব (ওজন) বাড়ানো হয়, এবং যেগুলো সঠিকভাবে শ্রেণীবদ্ধ হয়েছে, তাদের গুরুত্ব কমানো হয়। এর ফলে পরবর্তী দুর্বল লার্নারগুলো ভুল স্যাম্পলগুলোর উপর বেশি মনোযোগ দিতে বাধ্য হয়। প্রতিটি দুর্বল লার্নারকে তার নির্ভুলতার উপর ভিত্তি করে একটি নির্দিষ্ট পরিমাণ ওজন দেওয়া হয়। যে লার্নার যত বেশি নির্ভুল, তার ওজন তত বেশি হয়।
৪. ওজন আপডেট (Update Weights): স্যাম্পল এবং লার্নার উভয়ের ওজন আপডেট করা হয়। ভুলভাবে শ্রেণীবদ্ধ স্যাম্পলগুলোর ওজন বাড়ানো হয় যাতে পরবর্তী লার্নারগুলো সেগুলোর প্রতি বেশি মনোযোগ দেয়।
৫. পুনরাবৃত্তি (Iteration): ধাপ ২ থেকে ৪ নির্দিষ্ট সংখ্যক বার (যেমন n_estimators প্যারামিটারে নির্ধারিত) পুনরাবৃত্তি করা হয়। যতবার পুনরাবৃত্তি হয়, ততগুলো দুর্বল লার্নার তৈরি হয়।
৬. চূড়ান্ত ভবিষ্যৎবাণী (Final Prediction): সব দুর্বল লার্নার তৈরি হওয়ার পর, তাদের মিলিত ফলাফলের উপর ভিত্তি করে চূড়ান্ত ভবিষ্যৎবাণী করা হয়। প্রতিটি লার্নারের নিজস্ব নির্ভুলতার উপর ভিত্তি করে তাদের দেওয়া ওজন অনুসারে ফলাফল একত্রিত করা হয়। অধিক নির্ভুল লার্নারদের ভবিষ্যৎবাণীকে বেশি গুরুত্ব দেওয়া হয়।
কীভাবে কাজ করে?
AdaBoost এর কার্যপ্রণালীকে একটি দলগত কাজ হিসেবে ভাবা যেতে পারে। ধরুন, আপনি একটি নির্দিষ্ট সমস্যা সমাধানের জন্য কিছু মানুষকে দায়িত্ব দিয়েছেন।
- প্রথম ব্যক্তি (প্রথম দুর্বল লার্নার): সে সমস্যা সমাধানের চেষ্টা করে, কিন্তু কিছু ভুল করে।
- পর্যবেক্ষক (AdaBoost): সে দেখে, প্রথম ব্যক্তি কোন কোন বিষয়ে ভুল করেছে।
- দ্বিতীয় ব্যক্তি (দ্বিতীয় দুর্বল লার্নার): দ্বিতীয় ব্যক্তিকে সেই ভুল করা বিষয়গুলো সম্পর্কে বিশেষভাবে জানানো হয়, যাতে সে সেগুলোর উপর বেশি মনোযোগ দেয় এবং ভুলগুলো সংশোধন করতে পারে।
- এই প্রক্রিয়াটি চলতে থাকে, যতক্ষণে না একটি শক্তিশালী দল (চূড়ান্ত মডেল) তৈরি হয় যারা সম্মিলিতভাবে সমস্যার সমাধান করতে পারে।
মূলত, AdaBoost মিসক্লাসিফাইড স্যাম্পলগুলোকে (Misclassified Samples) বেশি ফোকাস করে এবং তাদের ওজন বাড়িয়ে দেয়, যাতে পরবর্তী দুর্বল লার্নারগুলো সেগুলোকে সঠিকভাবে শ্রেণীবদ্ধ করার চেষ্টা করে।
অ্যাডাবুস্ট ক্লাসিফায়ার এর সুবিধা ও অসুবিধা
সুবিধা:
- সহজবোধ্য এবং বাস্তবায়ন সহজ: এর মৌলিক ধারণা তুলনামূলকভাবে সহজ এবং এটি সহজেই প্রয়োগ করা যায়।
- উচ্চ নির্ভুলতা: এটি প্রায়শই অন্যান্য অ্যালগরিদমের তুলনায় উচ্চ নির্ভুলতা অর্জন করে, বিশেষ করে যখন দুর্বল লার্নারদের সঠিকভাবে টিউন করা হয়।
- ওভারফিটিং (Overfitting) প্রতিরোধ: যদিও এটি দুর্বল লার্নারদের উপর ভিত্তি করে তৈরি, এটি নির্দিষ্ট প্যারামিটার সেটিংস (যেমন
n_estimatorsএবংlearning_rateএর সঠিক টিউনিং) এর মাধ্যমে ওভারফিটিং প্রতিরোধ করতে সহায়তা করতে পারে। - আউটলায়ারদের (Outliers) প্রতি কম সংবেদনশীল: এটি আউটলায়ারদের প্রতি তুলনামূলকভাবে কম সংবেদনশীল।
অসুবিধা:
- নয়েজ ডেটার (Noisy Data) প্রতি সংবেদনশীল: যদি ডেটাসেটে অনেক নয়েজ থাকে, তাহলে AdaBoost সেগুলোকে অতিরিক্ত গুরুত্ব দিতে পারে, যা মডেলের পারফরম্যান্স খারাপ করতে পারে।
- আউটলায়ারদের প্রতি সংবেদনশীলতা (কিছু ক্ষেত্রে): যদিও এটি আউটলায়ারদের প্রতি কম সংবেদনশীল, অত্যন্ত ব্যতিক্রমী আউটলায়ারদের ক্ষেত্রে এটি পারফরম্যান্সকে প্রভাবিত করতে পারে।
- গণনায় সময়সাপেক্ষ: যেহেতু এটি ক্রমান্বয়ে একাধিক মডেলকে প্রশিক্ষণ দেয়, তাই এটি বড় ডেটাসেটের জন্য সময়সাপেক্ষ হতে পারে।
- বেজ লার্নার নির্বাচন: বেজ লার্নারের ধরন এবং প্যারামিটার নির্বাচন মডেলের পারফরম্যান্সের উপর প্রভাব ফেলে।
AdaBoostClassifier কখন ব্যবহার করবেন?
AdaBoostClassifier সাধারণত নিম্নলিখিত পরিস্থিতিতে ব্যবহার করা হয়:
- যখন উচ্চ নির্ভুলতার প্রয়োজন: যদি আপনার মডেলের নির্ভুলতা একটি গুরুত্বপূর্ণ বিষয় হয়, তাহলে AdaBoost একটি ভালো বিকল্প হতে পারে।
- যখন আপনার ডেটাসেট পরিষ্কার থাকে: এটি নয়েজবিহীন বা কম নয়েজযুক্ত ডেটাসেটের জন্য সেরা কাজ করে।
- যখন আপনার কাছে দুর্বল লার্নার থাকে: এটি ছোট এবং দুর্বল মডেলগুলোকে একত্রিত করে একটি শক্তিশালী মডেল তৈরি করতে সক্ষম। ডিসিশন ট্রি (বিশেষ করে ছোট ডিসিশন ট্রি, যেমন
max_depth=1) এর সাধারণ দুর্বল লার্নার হিসাবে ব্যবহার করা হয়। - শ্রেণীবদ্ধকরণ সমস্যা: এটি মূলত বাইনারি (Binary) বা মাল্টিক্লাস (Multiclass) শ্রেণীবদ্ধকরণ সমস্যার জন্য ব্যবহৃত হয়।
AdaBoostClassifier হলো এমন একটি শক্তিশালী মেশিন লার্নিং টুল, যা ভুলগুলোর উপর গুরুত্ব দিয়ে ধাপে ধাপে নিজের পারফরম্যান্স বাড়ায়। এটি নতুনদের জন্য একটি চমৎকার টপিক, কারণ এখানে মেশিন লার্নিং এর ‘শেখা থেকে শেখার’ ধারণাটি খুব স্পষ্টভাবে বোঝা যায়। আপনি যদি এখনও এনসেম্বল মেথড নিয়ে কাজ শুরু না করে থাকেন, তাহলে AdaBoost হতে পারে আপনার প্রথম চয়েস!
